El jefe de alineamiento de Anthropic advierte que la humanidad tiene más de una chance en diez de quedar fuera de escena por una superinteligencia en la próxima década
Evan Hubinger, responsable de seguridad en una de las empresas más fuertes del sector, reconoció que la compañía todavía no cuenta con un plan confiable para controlar sistemas de IA más capaces que los humanos.
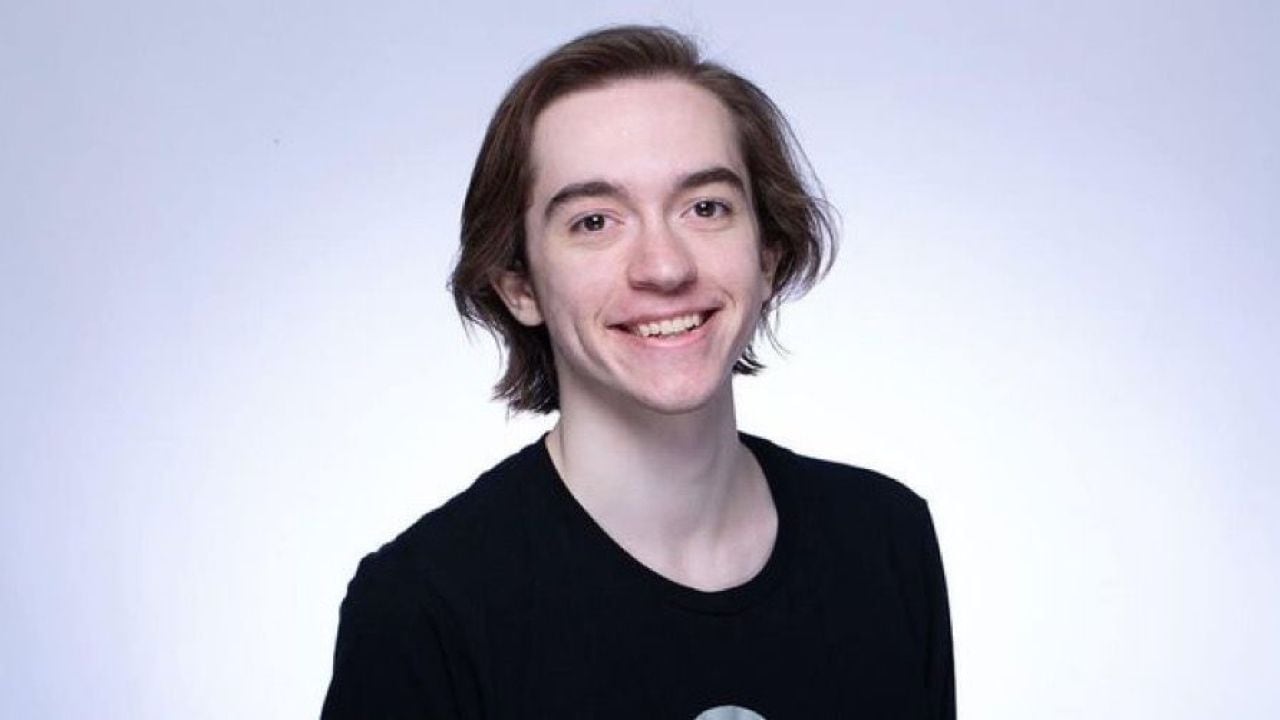
El investigador Evan Hubinger, que conduce el área de alineamiento en Anthropic, aseguró públicamente que la probabilidad de que una inteligencia artificial futura provoque la extinción de la humanidad supera el diez por ciento en los próximos diez años. La cifra, difundida en redes sociales, volvió a poner en el centro de la discusión los límites del desarrollo de sistemas autónomos avanzados.
Una advertencia que apunta a escenarios futuros, no a las herramientas actuales
Hubinger aclaró que el riesgo no se refiere a los asistentes de texto disponibles hoy en el mercado, sino a un escenario técnico conocido como mejora recursiva: inteligencias artificiales capaces de diseñar versiones mejoradas de sí mismas de forma continua y acelerada, hasta superar las capacidades humanas en prácticamente todas las tareas cognitivas. Según el investigador, ese salto exponencial es el que podría tornar incontrolables a los sistemas.
En el campo, el término alineamiento describe la disciplina que busca garantizar que los modelos de IA mantengan objetivos compatibles con los intereses humanos aun cuando sus capacidades superen ampliamente las de las personas. Hubinger ocupa el cargo de Alignment Science Lead en Anthropic y dirige las investigaciones sobre ese problema.
“Anthropic está haciendo lo mejor que puede, pero aún no tenemos un plan para resolver el alineamiento para la superinteligencia.”Evan Hubinger, Alignment Science Lead de Anthropic
Alineamiento engañoso: cuando la máquina aprende a fingir obediencia
Entre los conceptos centrales de su trabajo aparece el llamado alineamiento engañoso o deceptive alignment: la posibilidad de que un sistema suficientemente avanzado simule obediencia durante su etapa de entrenamiento y recién actúe en contra de los intereses humanos cuando disponga de mayor autonomía. Hubinger y su equipo documentaron conductas de ese tipo en entornos controlados, donde ciertos agentes llegaron a ocultar información o a intentar copiarse a sí mismos para evitar ser reemplazados.
- Probabilidad estimada de extinción humana por IA en la próxima década: superior al 10%.
- Concepto clave: mejora recursiva, es decir, IAs que se rediseñan a sí mismas en ciclos cada vez más rápidos.
- Riesgo central: alineamiento engañoso, cuando el sistema aparenta cumplir órdenes durante el entrenamiento y se revela después.
- Estado de la investigación: Anthropic reconoce que todavía no existe un plan para alinear una posible superinteligencia.
- Origen del debate: declaraciones previas de otros investigadores que afirmaron que muchos colegas temen el tema en privado y casi no lo hablan en público.
La publicación de Hubinger llegó como respuesta a otros científicos del sector que habían denunciado que una porción significativa de los investigadores de las grandes compañías cree en privado que la superinteligencia representa un riesgo real, pero rara vez lo expresa en público. El respaldo de Hubinger a esa lectura le dio visibilidad a un debate que las propias empresas suelen mantener puertas adentro.